MCP, MoE, 증류는 인공지능의 확장성과 효율성, 그리고 경량화를 판독하는 필수 지표입니다. 시스템 간 연결 방식과 모델의 내부 구조, 최적화 기법을 이해하고 데이터를 분석하여 저비용 고성능의 AI 생태계를 구축하는 핵심 확인 지침이 됩니다.
MCP (AI와 외부 세상을 잇는 공통 규격)
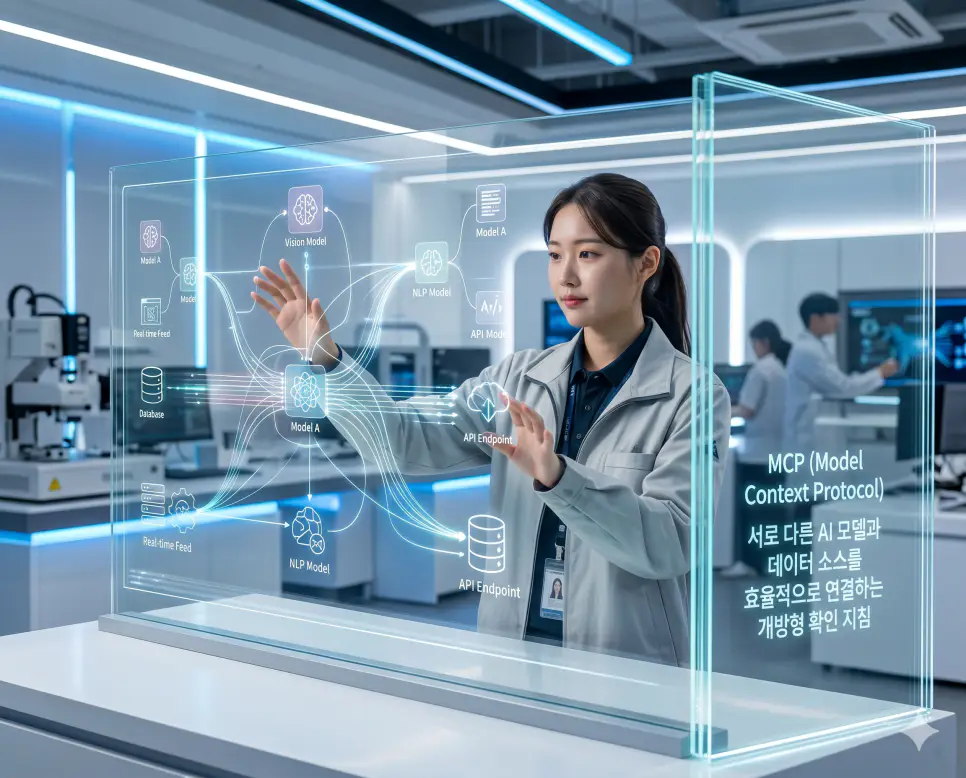
MCP는 ‘모델 컨텍스트 프로토콜’의 약자로, AI 모델이 외부 데이터나 도구(로컬 파일, 데이터베이스 등)에 안전하고 쉽게 접근할 수 있도록 만든 개방형 연결 표준 데이터 확인 지침 용어입니다. 안쓰로픽(Anthropic)에서 처음 제안했으며, 서로 다른 AI 서비스들이 공통된 방식으로 소통할 수 있게 돕는 데이터로 판독됩니다.
개발자들이 매번 새로운 연결 통로를 만들 필요 없이 표준화된 규격을 사용하게 하려는 생태계 통합 방침이 반영된 결과입니다. 이는 AI 대중화 시대의 ‘상호 운용성’을 결정하는 실질 지표가 되며, MCP 호환 서버와 클라이언트 간의 데이터 흐름을 정밀하게 판독하여 나만의 맞춤형 AI 환경을 구축하는 시스템 관리 지침으로 활용됩니다.
MCP 분석 및 연결 수칙
MCP는 인공지능이 로컬 자산을 직접 다루게 하므로 보안 설정이 중요합니다. 효율적인 도구 연동을 위한 정보성 대응 수칙은 다음과 같습니다.
호스트와 서버 간의 프로토콜 규격 데이터 판독 수칙
AI 에이전트와 외부 도구가 주고받는 데이터 패킷이 표준 규격에 맞게 설계되었는지 정밀하게 판독하는 연결 진단 지침입니다.
로컬 파일 및 데이터베이스 접근 권한 확인 이행
AI가 내 컴퓨터의 특정 폴더나 DB에 접근할 때 허용된 범위 데이터 지표 내에서 작동하는지 확인하는 보안 관리 방침입니다.
오픈 소스 서버 라이브러리 활용 및 판별 수칙
구글 검색, 깃허브(GitHub), 슬랙(Slack) 등 이미 만들어진 MCP 서버 데이터 지표를 활용할 수 있는지 판별하는 수칙입니다.
멀티 에이전트 간 컨텍스트 공유 전략
여러 개의 AI가 MCP를 통해 하나의 문맥 데이터를 공유하며 협업하는 구조를 분석하여 업무 생산성을 높이는 대응 방침입니다.
기술적 연관 체계
시스템 간의 인터페이스와 통합을 규정하는 보조 정보입니다.
유의어
- 상호운용성 표준: 기기나 소프트웨어가 서로 통신하기 위해 정한 약속 확인 지표입니다.
- AI 플러그인 규격: 특정 모델에 기능을 추가하는 방식의 표준화된 확인 데이터입니다.
- 에코시스템 게이트웨이: 외부 생태계와 AI를 연결하는 통로 확인 지침입니다.
반대어
- 폐쇄형 아키텍처: 외부 연동 없이 모델 내부 자원만 사용하는 대조 확인 지표입니다.
- 독자 규격: 특정 회사만 사용하는 호환성 없는 확인 방침입니다.
관련 용어
- SDK: MCP 기반 도구를 개발할 때 사용하는 소프트웨어 개발 키트 확인 수칙입니다.
- API: 프로그램 간 정보를 주고받는 접점으로 MCP의 기초가 되는 지표입니다.
- 에이전트: MCP를 통해 스스로 도구를 사용하는 자율형 AI 확인 지침입니다.
MoE (효율적인 거대 지능을 위한 전문가 팀워크)
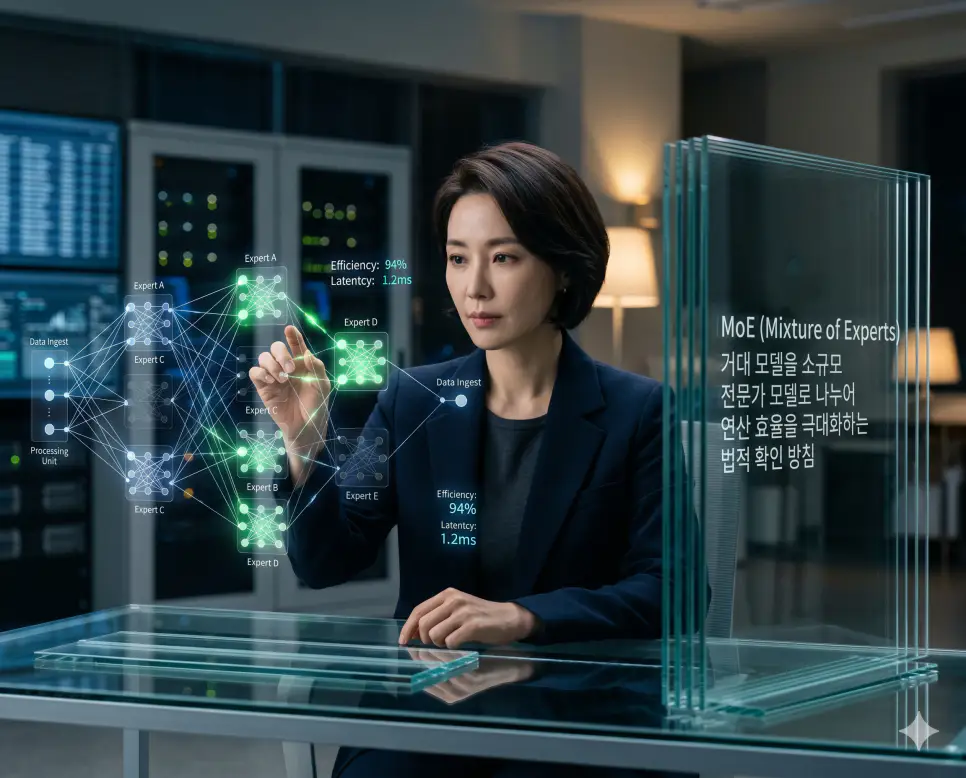
MoE는 ‘전문가 혼합’ 구조로, 하나의 거대한 신경망을 여러 개의 작은 전문가(Expert) 망으로 쪼개어 관리하는 모델 데이터 확인 방침 용어입니다. 모든 연산에 전체 신경망을 다 쓰지 않고, 질문에 가장 적합한 특정 전문가들만 골라서 활성화하는 데이터로 판독됩니다.
모델의 전체 크기는 키우면서도 실제 계산량(비용)은 낮게 유지하려는 연산 최적화 방침 이행 결과입니다. 이는 현대 거대 언어 모델(LLM)의 ‘가성비와 속도’를 결정하는 핵심 지표가 되며, 게이팅 네트워크(Gating Network)의 라우팅 데이터 데이터를 정밀하게 판독하여 추론 성능 대비 효율적인 하드웨어 운용 지침으로 활용됩니다.
MoE 조사 및 아키텍처 수칙
MoE는 ‘선택과 집중’을 통해 성능을 냅니다. 고효율 모델 운영을 위한 대응 방침은 다음과 같습니다.
전문가 모델의 개수 및 활성화 비율 데이터 판독 수칙
전체 파라미터 중 한 번의 추론에 실제로 쓰이는 ‘활성 파라미터’ 데이터가 몇 %인지 정밀하게 판독하는 성능 진단 지침입니다.
라우터(Router)의 분배 정확도 확인 이행
질문 내용에 맞춰 적절한 전문가에게 데이터를 정확히 배분하고 있는지 확인하는 학습 효율 관리 방침입니다.
추론 속도 및 GPU 메모리 점유율 판별 수칙
모델은 크지만 실제 연산 속도가 빠른지, 메모리에 전체 전문가를 다 올릴 수 있는지 판별하는 인프라 수칙입니다.
전문가 간 지식 겹침(Overlapping) 분석 전략
각 전문가 모델이 서로 다른 분야의 지식을 특화하여 보유하고 있는지 데이터를 분석하는 최적화 대응 방침입니다.
기술적 연관 체계
신경망의 분산 및 선택적 처리를 설명하는 보조 정보입니다.
유의어
- 조건부 계산: 입력값에 따라 필요한 부분만 계산하는 확인 지표입니다.
- 분산 지능 구조: 지능을 여러 모듈로 나누어 배치한 성격의 확인 데이터입니다.
- 동적 신경망: 데이터 흐름에 따라 구조가 변하는 확인 지침입니다.
반대어
- 밀집 모델 (Dense Model): 모든 입력에 대해 전체 신경망을 다 연산하는 전통적 대조 확인 지표입니다.
- 단일 신경망: 쪼개지지 않은 하나의 덩어리로 된 확인 방침입니다.
관련 용어
- 게이팅 네트워크: 어떤 전문가를 쓸지 결정하는 의사결정망 확인 수칙입니다.
- Mixtral / GPT-4: MoE 구조를 채택한 대표적인 인공지능 모델 데이터 지표입니다.
- 토큰 라우팅: 단어 단위로 전문가를 배정하는 기술적 확인 지침입니다.
증류 (거인으로부터 지능만 쏙 뽑아내는 기술)
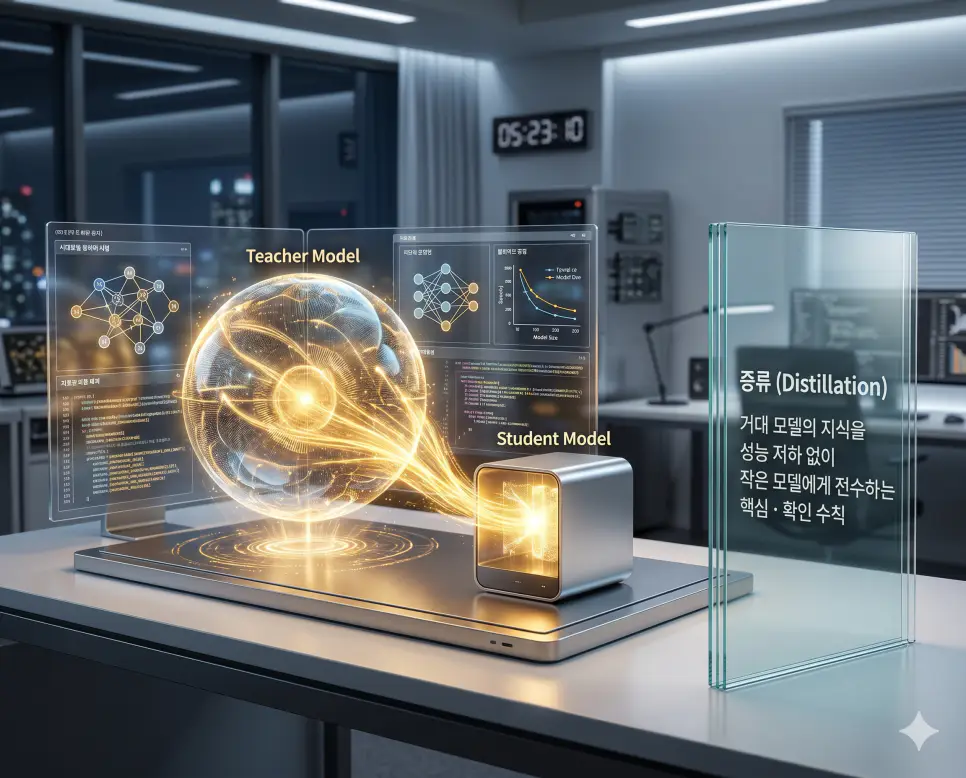
증류(Knowledge Distillation)는 성능이 뛰어난 거대 모델(교사, Teacher)의 지식을 훨씬 작고 가벼운 모델(학생, Student)로 압축하여 전수하는 학습 데이터 확인 수칙 용어입니다. 교사 모델이 내놓는 답변의 확률 분포 데이터를 학생 모델이 따라 배우게 하여, 작은 크기로도 큰 모델에 근접한 성능을 내게 하는 데이터로 판독됩니다.
고사양 GPU 없이도 모바일이나 엣지 기기에서 AI가 빠르게 돌아가도록 하려는 모델 경량화 방침이 반영된 결과입니다. 이는 AI 서비스의 ‘현장 적용성’을 결정하는 최종 지표가 되며, 교사와 학생 간의 손실 함수(Loss Function) 데이터 데이터를 정밀하게 판독하여 지식 전수 과정에서의 정보 손실을 최소화하는 기술 고도화 지침으로 활용됩니다.
증류 분석 및 최적화 수칙
증류를 거친 모델은 원래 크기보다 훨씬 빠르고 저렴합니다. 실무형 모델 구축을 위한 정보성 수칙은 다음과 같습니다.
교사 모델과 학생 모델의 성능 격차 데이터 판독 수칙
압축 전후의 정확도 차이가 실무에서 허용 가능한 범위 데이터인지 정밀하게 판독하는 품질 진단 지침입니다.
소프트 타겟(Soft Target) 확률 분포 확인 이행
단순히 정답만 맞히는 게 아니라, 오답 후보들 간의 관계 데이터까지 깊이 있게 전수받는지 확인하는 학습 방침입니다.
경량화 배수 및 추론 속도 개선율 판별 수칙
모델 크기를 몇 배나 줄였으며, 실제 서비스 로딩 속도 데이터 지표가 얼마나 개선되었는지 판별하는 수칙입니다.
온디바이스 AI(On-device) 적용 가능성 전략
클라우드 연결 없이 기기 내부에서만 돌아갈 수 있을 정도로 가벼워졌는지 데이터를 분석하는 대응 방침입니다.
기술적 연관 체계
지식 전수와 모델 최적화 과정을 설명하는 관련 정보입니다.
유의어
- 지식 전이: 한 모델의 역량을 다른 모델로 옮기는 확인 지표입니다.
- 모델 압축: 성능 유지와 크기 감소를 동시에 도모하는 확인 데이터입니다.
- 경량 학습: 가벼운 구조에서 효율을 뽑아내는 성격의 확인 지침입니다.
반대어
- 원형 학습: 아무런 가이드 없이 데이터셋으로만 처음부터 배우는 대조 확인 지표입니다.
- 거대화: 성능 향상을 위해 모델 크기만 계속 키우는 정반대의 확인 방침입니다.
관련 용어
- 손실 함수 (Loss): 교사의 가르침과 학생의 결과 사이의 차이를 계산하는 확인 수칙입니다.
- 양자화 (Quantization): 데이터의 정밀도를 낮춰 더 가볍게 만드는 유사 경량화 지표입니다.
- TinyML: 아주 작은 칩셋에서도 돌아가는 초경량 AI 확인 지침입니다.
FAQ
과거에는 AI가 내 컴퓨터의 파일을 읽게 하려면 복잡한 코딩을 매번 새로 해야 했습니다. 하지만 MCP라는 표준 데이터 규격을 쓰면, 이미 만들어진 ‘MCP 서버’ 데이터만 가져다 쓰면 됩니다. 레고 블록을 끼우듯 AI에게 새로운 능력(검색, 코딩 도구 등)을 즉시 부여할 수 있는 확장성 방침이 가장 큰 장점입니다.
전체 근육(신경망)은 아주 많지만, 실제로 물건을 들 때(답변할 때)는 필요한 근육 몇 가지만 쓰기 때문입니다. 전체 파라미터 데이터는 수천억 개일지라도 실제 계산에 쓰이는 데이터 지표는 수백억 개 수준으로 판독되므로, 하드웨어 부담을 줄이면서도 똑똑한 답변을 내놓는 효율적 방침이 작용합니다.
어느 정도의 성능 하락은 있지만, 크기 대비 성능은 비약적으로 올라갑니다. 거대 모델(교사)이 ‘왜 이 답을 골랐는지’에 대한 복잡한 확률 데이터까지 학생 모델에게 가르치기 때문입니다. 100점짜리 거인에게 배운 90점짜리 소인 데이터가 처음부터 혼자 공부한 80점짜리 모델보다 훨씬 훌륭한 방침이 됩니다.
대체로 ‘증류’ 기법과 ‘양자화’ 기술이 핵심입니다. 거대한 클라우드 AI의 핵심 데이터 지능만 증류하여 작게 만들고, 이를 폰 안에서 돌리는 ‘온디바이스 AI’ 방침을 사용합니다. 덕분에 데이터 연결 없이도 실시간 번역이나 사진 편집 기능 데이터를 판독할 수 있게 됩니다.
메모리 요구량이 큽니다. 연산(속도)은 빠르지만, 수많은 전문가 모델 데이터 전체를 일단 메모리에 올려두어야 하기 때문입니다. 즉, “머리는 엄청 큰데 실제 생각하는 뇌 영역은 조금만 쓴다”는 데이터 판독 방침이므로, 비싼 GPU 메모리가 많이 필요한 것이 고질적인 숙제입니다.